La regresión lineal múltiple estima cuánto cambia una variable dependiente continua cuando cambia cada predictor, manteniendo constantes los demás. En SPSS la ruta es Analizar > Regresión > Lineales, pero el orden que importa no es el de los menús: primero se estima el modelo pidiendo los diagnósticos, después se revisan los cinco supuestos sobre esa misma salida y solo al final se interpretan los coeficientes.
Casi todas las tesis que regresan corregidas de la revisión metodológica cometen el mismo error: interpretan los coeficientes antes de haber comprobado que el modelo tiene derecho a producirlos. Esta guía va en el orden real de trabajo.
Cuándo te toca una regresión múltiple (y cuándo no)
La prueba se elige por la forma de tus variables, no por lo sofisticada que suene. Necesitas exactamente esto:
- Una variable dependiente continua: puntaje, ingreso, calificación, tiempo, un índice sumado de una escala.
- Dos o más predictores, continuos o categóricos convertidos en variables ficticias.
- Una hipótesis de relación, no de diferencia entre grupos. Si tu pregunta es «¿difieren los grupos?», tu prueba es otra.
Si tu dependiente es dicotómica (aprobó / no aprobó) la regresión lineal no aplica: ahí va una regresión logística. Y si tienes un solo predictor, es regresión simple y toda esta guía sigue valiendo salvo la parte de multicolinealidad, que necesita al menos dos. La tabla de correspondencia entre tipo de variable y prueba está en análisis de datos cuantitativos en la tesis, y conviene tenerla a la vista antes de decidir.
Antes de seguir, revisa que la hipótesis esté redactada como relación entre variables y no como una corazonada: hipótesis de investigación con ejemplos muestra la diferencia de redacción, que es la que después te van a preguntar.
Cuántos casos necesitas
La referencia más citada es la de Green (1991), en Multivariate Behavioral Research, 26(3), 499-510: N ≥ 50 + 8m si te interesa el modelo global y N ≥ 104 + m si vas a interpretar cada coeficiente por separado, donde m es el número de predictores. Con cinco predictores son 90 y 109 casos; manda la cifra mayor, porque en una tesis casi siempre interpretas los coeficientes uno por uno.
Esa regla es un piso, no un cálculo de potencia. Si tu comité pide justificar el tamaño de muestra con un procedimiento formal, la ruta está en cómo calcular el tamaño de muestra de tu tesis.
Los cinco supuestos, en el orden en que conviene revisarlos
Dos se revisan antes de correr nada; tres solo pueden revisarse después, porque se calculan sobre los residuos del modelo ya estimado. De ahí que la secuencia práctica sea: revisar lo revisable, correr el modelo con todos los diagnósticos activados, revisar el resto y solo entonces leer los resultados.
| Supuesto | Qué significa | Con qué se revisa | Cuándo |
|---|---|---|---|
| Linealidad | La relación entre cada predictor y la dependiente es una línea, no una curva | Diagramas de dispersión de la dependiente contra cada predictor | Antes |
| Ausencia de multicolinealidad | Los predictores no son casi la misma variable entre sí | VIF y tolerancia en la tabla de coeficientes | Después |
| Independencia de los residuos | El error de un caso no predice el del siguiente | Estadístico Durbin-Watson | Después |
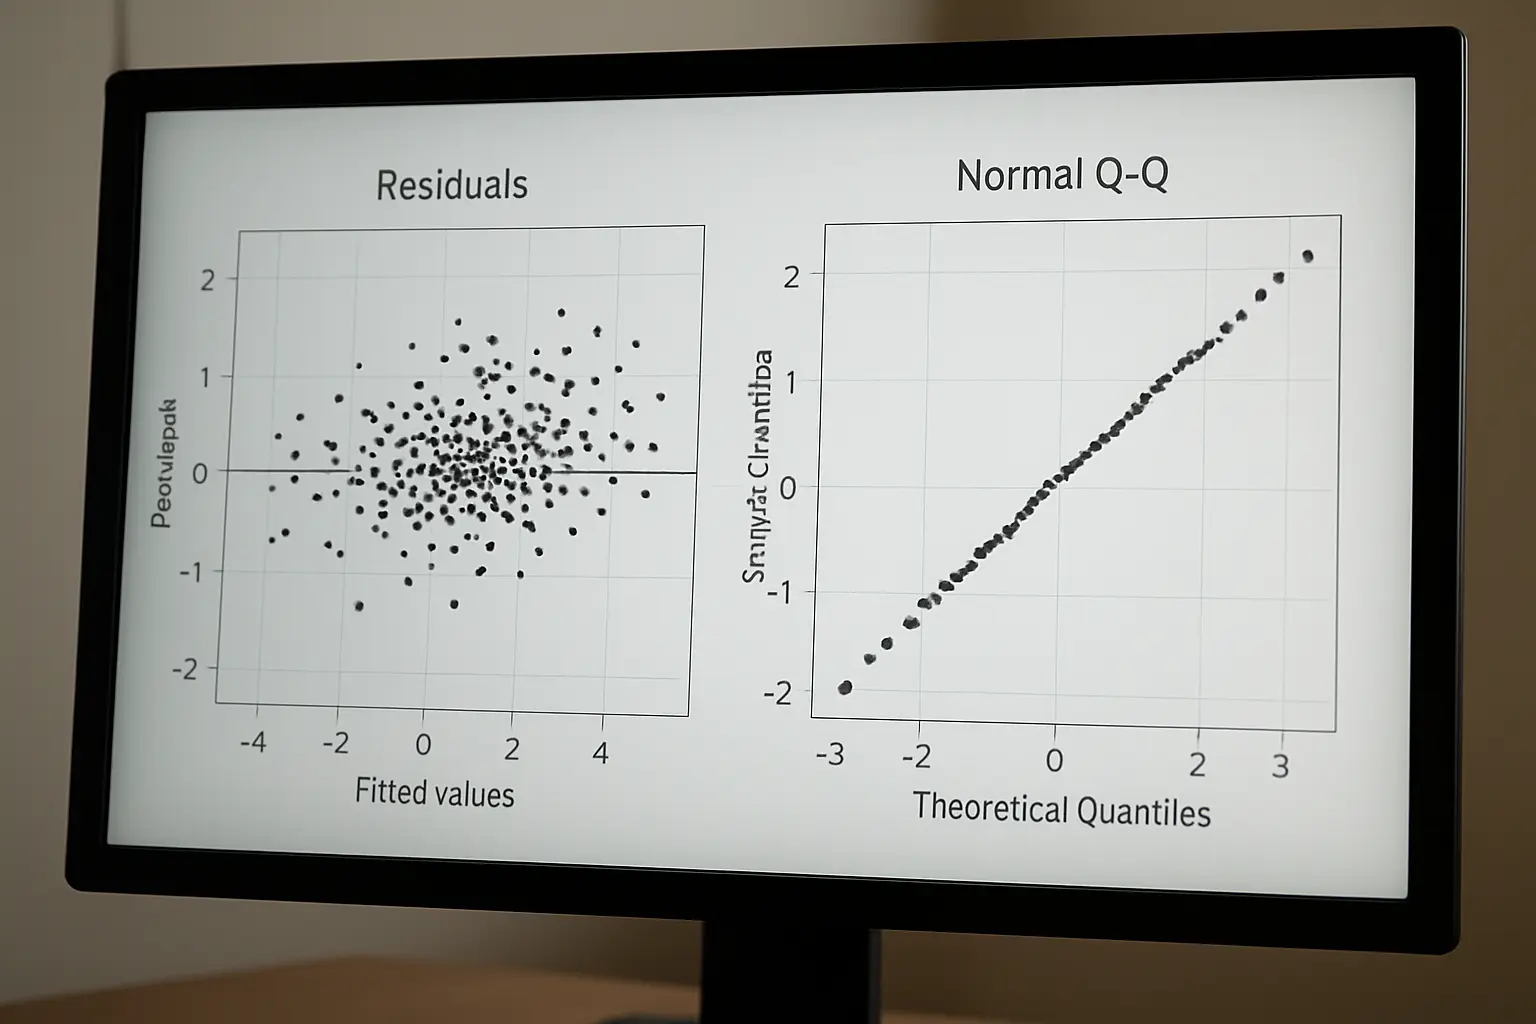
| Homocedasticidad | La dispersión del error es pareja en todo el rango de predicción | Residuos tipificados contra valores pronosticados tipificados | Después |
| Normalidad de los residuos | Los errores se distribuyen normalmente (no los datos crudos) | Histograma de residuos y gráfico P-P normal | Después |
Fíjate en la última fila, porque es el malentendido más caro de esta prueba: la regresión no exige que tus variables sean normales. Exige que lo sean los residuos. Un ingreso mensual con una cola larga a la derecha puede entrar perfectamente en un modelo cuyos residuos son normales, y mucha gente descarta el análisis sin necesidad por revisar la variable equivocada.
Paso a paso en SPSS
- Prepara las variables. La dependiente debe estar declarada como escala en la vista de variables. Cada predictor categórico se convierte en variables ficticias: eliges una categoría como referencia y creas una dicotómica para cada una de las restantes. Con tres categorías entran dos ficticias, nunca tres.
- Abre el procedimiento: Analizar > Regresión > Lineales. La dependiente va en Dependiente y todos los predictores en Independientes. Deja el método en Introducir salvo que tengas una razón teórica declarada para lo contrario.
- Botón Estadísticos: activa Estimaciones, Intervalos de confianza, Ajuste del modelo, Diagnósticos de colinealidad y, en el bloque de residuos, Durbin-Watson y Diagnósticos por caso.
- Botón Gráficos: coloca *ZRESID en el eje Y y *ZPRED en el eje X, y marca Histograma y Gráfico de probabilidad normal. Estos tres gráficos cubren tres de los cinco supuestos.
- Botón Guardar: marca Distancia de Cook. Te va a servir para detectar casos influyentes sin salir del mismo procedimiento.
- Acepta y trabaja sobre la salida en el orden de la siguiente sección.
El método Introducir mete todos los predictores a la vez y es el que se defiende sin problema. Los métodos automáticos por pasos deciden por ti qué variables entran usando solo criterios estadísticos, y en un examen de grado esa decisión te la van a pedir justificar teóricamente. Si tu marco no la justifica, no la uses.
Cómo se lee la salida: las tres tablas que importan
1. Resumen del modelo
Aquí vive el R cuadrado ajustado, que es el que se reporta. El R cuadrado sin ajustar sube siempre que agregas un predictor, aporte o no; el ajustado penaliza esa inflación según el número de predictores y el tamaño de muestra. Una brecha grande entre los dos es señal de que hay variables de más.
Un R² ajustado de 0.34 significa que el modelo explica el 34 % de la variabilidad de la dependiente. No hay un umbral universal de «aceptable»: en ciencias sociales con datos de encuesta, cifras entre 0.10 y 0.40 son habituales, y presentarlas como decepcionantes es un error de expectativas, no de análisis.
En esta misma tabla aparece el Durbin-Watson. Se mueve entre 0 y 4, y el valor esperado bajo independencia es 2. La regla de trabajo habitual es que valores entre 1.5 y 2.5 no dan motivo de alarma. Si tus datos no tienen orden temporal ni de agrupamiento, este supuesto rara vez se viola.
2. Tabla ANOVA
Responde una sola pregunta: ¿el conjunto de predictores explica algo más que el azar? Si la significancia es menor a 0.05, el modelo global sirve. Si no lo es, no tiene caso interpretar coeficientes individuales, por muy bonitos que se vean.
3. Tabla de coeficientes
Es la tabla que responde tu hipótesis, y tiene cuatro columnas que hay que leer juntas:
- B (no estandarizado): cuánto cambia la dependiente por cada unidad del predictor, con los demás constantes. Está en las unidades originales, así que es lo que se explica en prosa.
- Beta (estandarizado): el mismo efecto en desviaciones estándar. Sirve para comparar la fuerza de predictores medidos en escalas distintas, y solo para eso.
- Sig.: si el coeficiente se distingue de cero.
- VIF y tolerancia: el diagnóstico de multicolinealidad. Un VIF por debajo de 10 es el umbral que la mayoría de los comités acepta; muchos autores prefieren 5. La tolerancia es 1 dividido entre el VIF, de modo que una tolerancia menor a 0.10 y un VIF mayor a 10 dicen exactamente lo mismo.
Qué hacer cuando un supuesto falla
Que un supuesto falle no cancela tu tesis. Cancela la interpretación ingenua, que es distinto.
| Lo que ves | Qué está pasando | Qué se hace |
|---|---|---|
| Modelo global significativo, ningún predictor significativo | Multicolinealidad, casi con seguridad | Revisa los VIF; conserva el predictor mejor fundamentado teóricamente y elimina o combina el otro |
| Los residuos forman un embudo que se abre | Heterocedasticidad | Transforma la dependiente (logaritmo, raíz) o reporta errores estándar robustos, declarando la decisión |
| La nube de dispersión describe una curva | La relación no es lineal | Añade el término cuadrático del predictor, o transforma la variable |
| El P-P normal se separa mucho de la diagonal | Residuos no normales | Con muestras grandes suele ser tolerable; con muestras chicas, busca casos extremos antes que descartar el modelo |
| Distancia de Cook mayor a 1 en algún caso | Un caso influyente está moviendo el modelo entero | Revísalo uno por uno: si es un error de captura se corrige, si es un dato real se reporta con y sin él |
La regla que sostiene toda esta tabla: cada decisión que tomes sobre los datos se escribe en la tesis. Un modelo con una transformación logarítmica declarada es defendible; el mismo modelo sin declarar la transformación no lo es.
Cómo se reporta en el texto
El apartado de resultados presenta los números y se guarda la interpretación teórica para el siguiente capítulo. El orden que funciona es: primero el modelo global (R² ajustado, F, gl, significancia), luego los coeficientes en una tabla y en el texto solo los que responden hipótesis.
La tabla se formatea con las reglas de tablas y figuras en APA 7, y la redacción del apartado completo está en cómo redactar los resultados de tu tesis paso a paso. La lectura sustantiva —qué significa que ese predictor pese más que el otro— pertenece a la discusión de resultados, y mezclar ambas cosas es la observación que más se repite en las revisiones de forma.
Si ya tienes la salida y lo que te falta es convertirla en párrafos con el registro académico correcto, Tesify ayuda con esa redacción. Lo que no hace: no decide por ti qué predictores entran al modelo, no revisa tus supuestos y no interpreta tus coeficientes; esa parte es tuya y es exactamente la que el sínodo va a examinar.
Errores que se detectan de inmediato
- Meter una variable categórica sin convertirla en ficticias. SPSS te va a dar números y todos van a ser basura.
- Interpretar Beta como «porcentaje de influencia». Beta está en desviaciones estándar; no es un porcentaje de nada.
- Revisar la normalidad de las variables en lugar de la de los residuos.
- Usar un método por pasos y presentarlo como si el modelo fuera teórico.
- Reportar el R² sin ajustar en una regresión múltiple.
- Redondear la significancia a 0.000. Se escribe p < .001; el cero exacto no existe.
Si vas a describir el procedimiento en el capítulo metodológico y no solo en resultados, la estructura de ese apartado está en metodología de una tesis con ejemplo, y la comparación entre programas por si estás decidiendo con cuál trabajar, en SPSS vs jamovi vs R.
Preguntas frecuentes
¿Cuántos casos necesito para una regresión lineal múltiple?
La regla de referencia más citada es la de Green (1991): al menos 50 más 8 veces el número de predictores si te interesa el modelo global, y al menos 104 más el número de predictores si vas a interpretar cada coeficiente por separado. Con cinco predictores eso son 90 y 109 casos respectivamente, y manda la cifra más alta.
¿Los supuestos se revisan antes o después de correr el modelo?
Tres de ellos solo pueden revisarse después, porque se calculan sobre los residuos del modelo ya estimado. Por eso el orden real es: correr la regresión pidiendo los diagnósticos, revisar los supuestos con esa salida y solo entonces interpretar los coeficientes. Interpretar antes de revisar es el error más común.
¿Qué valor de VIF es aceptable?
El umbral que la mayoría de los comités acepta es un VIF por debajo de 10, y muchos autores prefieren un criterio más estricto de 5. La tolerancia es simplemente 1 dividido entre el VIF, así que una tolerancia menor a 0.10 equivale a un VIF mayor a 10 y señala el mismo problema.
¿Puedo meter una variable categórica como predictor?
Sí, pero no en su forma original. Hay que convertirla en variables ficticias: una categoría se elige como referencia y se crea una variable dicotómica para cada una de las demás. Con tres categorías entran dos variables ficticias, y cada coeficiente se lee como la diferencia respecto a la categoría de referencia.
¿Qué diferencia hay entre el R cuadrado y el R cuadrado ajustado?
El R cuadrado siempre sube al añadir predictores, aunque no aporten nada. El ajustado penaliza esa inflación según el número de predictores y el tamaño de la muestra. En una regresión múltiple se reporta el ajustado, y una brecha grande entre ambos indica que hay predictores de más.
¿Qué hago si el modelo global es significativo pero ningún predictor lo es?
Es la firma clásica de la multicolinealidad. El conjunto de predictores explica la variable dependiente, pero están tan correlacionados entre sí que ninguno puede atribuirse un efecto propio. Revisa los VIF antes de concluir cualquier otra cosa.