Si tu tesis compara dos grupos, correlaciona variables o ajusta una regresión, la fórmula de poblaciones finitas no responde tu pregunta. Esa fórmula dimensiona una estimación; tú necesitas dimensionar un contraste. Para eso existe el análisis de potencia, y G*Power lo resuelve en cinco campos.
El escenario típico: tu asesora aprobó el protocolo, calculaste 384 encuestas con la fórmula que traía el libro y ahora el comité pregunta «¿y con esa muestra qué diferencia mínima puedes detectar?». Son dos preguntas distintas y solo una la contesta la fórmula. Si la tuya es la segunda, esta guía es el procedimiento.
Para la primera —estimar una proporción en una población conocida— la ruta está completa en cómo calcular el tamaño de la muestra, con la fórmula, los parámetros y el ejemplo numérico. Aquí seguimos desde donde esa guía apunta a G*Power.
Por qué importa: el dato incómodo
Una revisión metodológica publicada en 2026 en el Journal of Conservative Dentistry and Endodontics analizó los artículos originales publicados en esa revista entre enero de 2021 y diciembre de 2025. De 631 artículos elegibles, solo 176 (27.9 %) reportaron un cálculo de tamaño de muestra. Y de esos, el reporte completo y metodológicamente coherente se identificó en apenas 9 estudios: el 1.43 % del total.
Los autores identifican con precisión dónde falla: los elementos que más se omiten son el método de cálculo y el tamaño del efecto, mientras que el nivel de significancia y la potencia sí se reportan casi siempre. Y detectaron inconsistencias frecuentes entre el cálculo de muestra y la prueba estadística finalmente aplicada. G*Power fue el software más usado entre quienes sí lo hicieron.
Ese último punto es el eje de esta guía. El error dominante no es el número: es que el cálculo se hizo para una prueba y el capítulo 4 corrió otra.
Las cinco decisiones (que son las cinco pantallas)
G*Power es intimidante porque abre con una interfaz densa, pero solo tienes que llenar cinco cosas en orden.
1. Test family y Statistical test: la familia de la prueba que vas a correr
Esta es la decisión que la revisión encontró rota más seguido. Elige aquí exactamente el análisis de tu capítulo de resultados:
| Tu análisis | Test family | Statistical test |
|---|---|---|
| Comparar dos grupos independientes | t tests | Means: Difference between two independent means (two groups) |
| Comparar antes y después en las mismas personas | t tests | Means: Difference between two dependent means (matched pairs) |
| Comparar tres o más grupos | F tests | ANOVA: Fixed effects, omnibus, one-way |
| Correlación entre dos variables numéricas | Exact | Correlation: Bivariate normal model |
| Regresión múltiple | F tests | Linear multiple regression: Fixed model, R² deviation from zero |
| Tablas de contingencia | χ² tests | Goodness-of-fit tests: Contingency tables |
2. Type of power analysis: A priori
El menú ofrece varias opciones y solo una es la que necesitas al planear: «A priori: Compute required sample size». Las otras responden preguntas distintas —qué potencia tenías, qué efecto era detectable— y volveremos a ellas al final.
3. Tails: una o dos colas
Dos colas por defecto. Una sola cola exige que tu hipótesis sea direccional y que hayas declarado la dirección antes de recolectar. Es tentador porque reduce la muestra requerida, y es justo por eso que un comité lo revisa: si no lo justificaste en el capítulo 1, no lo uses aquí.
4. Effect size: el campo que decide todo
Este es el número que más pesa en el resultado y el que más se omite en los reportes. Cada familia usa su propio índice:
- d de Cohen para diferencias de medias. Convenciones: 0.2 pequeño, 0.5 mediano, 0.8 grande.
- f de Cohen para ANOVA: 0.10 pequeño, 0.25 mediano, 0.40 grande.
- r para correlaciones: 0.10, 0.30, 0.50.
- f² para regresión múltiple: 0.02, 0.15, 0.35.
- w para chi cuadrada: 0.10, 0.30, 0.50.
De dónde sacarlo, en orden de preferencia y de solidez ante un comité:
- Un estudio previo con el mismo instrumento y una población parecida. Es la mejor justificación posible: se cita y se acabó.
- Un metaanálisis del área, que promedia varios estudios y es más estable que uno solo.
- Tu prueba piloto, si la hiciste con suficientes casos. Declara que la estimación proviene de ahí.
- Las convenciones de Cohen, como último recurso. Elegir «efecto mediano» sin más es lo que hacen muchos trabajos, y se acepta, pero es el argumento más débil de los cuatro.
Lo que nunca se hace: tomar el efecto que obtuviste en tus datos definitivos para «justificar» retroactivamente la muestra. Eso es circular y se nota.
G*Power incluye un panel «Determine» que calcula la d a partir de medias y desviaciones estándar de un estudio previo. Úsalo: es más defendible que teclear 0.5.
5. α, potencia y razón de asignación
- α err prob: 0.05, la convención.
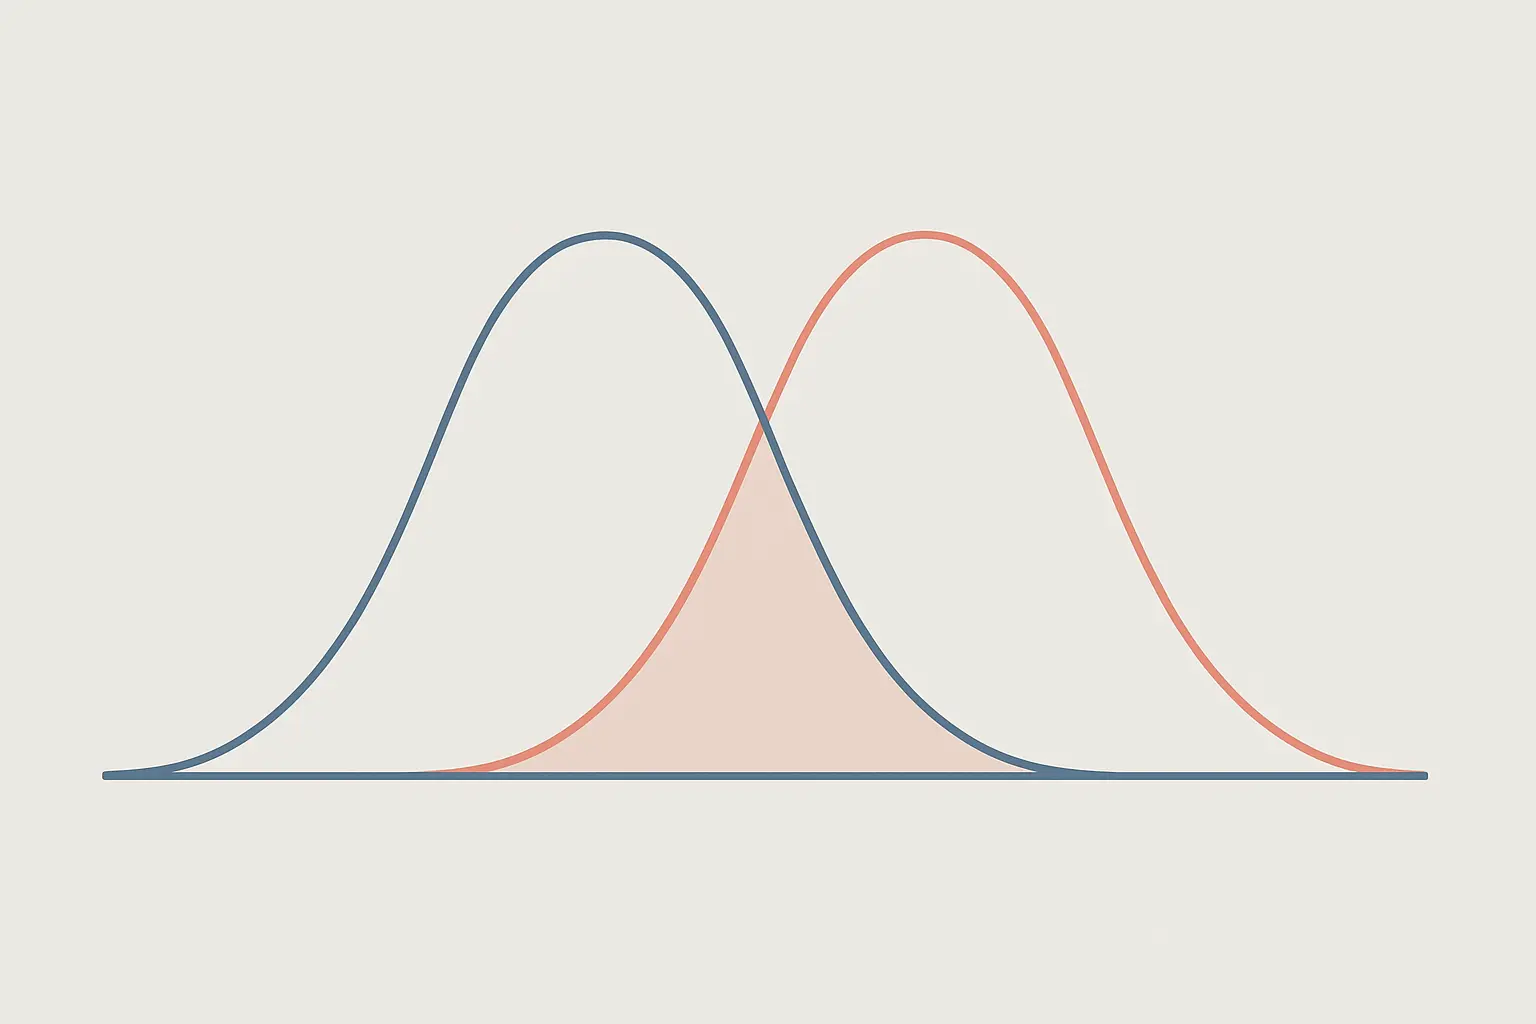
- Power (1−β err prob): 0.80. Significa 80 % de probabilidad de detectar el efecto si existe. Algunos comités piden 0.90 en estudios con implicaciones clínicas; el costo es una muestra bastante mayor.
- Allocation ratio N2/N1: 1 si esperas grupos del mismo tamaño. Si sabes que un grupo será el doble, pon 2: la muestra total sube, y ocultar el desbalance solo hace que la cifra sea falsa.
Presiona Calculate y G*Power devuelve el Total sample size, además del parámetro de no centralidad y el valor crítico. El número que va a tu protocolo es el total, repartido según tu razón de asignación.
Cómo se reporta en la metodología
Un párrafo completo incluye los seis elementos que la revisión de 2026 encontró incompletos en el 98.6 % de los casos: software y versión, prueba, tamaño del efecto con su origen, α, potencia y resultado.
«El tamaño de muestra se determinó mediante un análisis de potencia a priori con G*Power 3.1 (Faul et al., 2009) para una prueba t de diferencia de medias entre dos grupos independientes, con contraste bilateral. Se asumió un tamaño del efecto mediano (d = 0.50), estimado a partir de las medias y desviaciones reportadas por [Autor, año] con el mismo instrumento en población universitaria mexicana, un nivel de significancia de α = .05 y una potencia de 1−β = .80, con razón de asignación 1:1. El análisis arrojó un tamaño mínimo de 128 participantes (64 por grupo). Considerando una pérdida esperada del 15 %, se planeó reclutar 148.»
Ese último detalle —el ajuste por pérdida— es el que separa un cálculo de escritorio de un plan de campo. Nadie recolecta el 100 % de lo que planea.
Las referencias que se citan
G*Power se cita, y las dos referencias canónicas son:
- Faul, F., Erdfelder, E., Lang, A.-G., y Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191.
- Faul, F., Erdfelder, E., Buchner, A., y Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149–1160.
Cita la de 2009 si tu análisis es de correlación o regresión, y la de 2007 en los demás casos. El formato de la entrada de referencia está en cómo citar un artículo científico en APA 7; el programa en sí, como software, sigue las reglas de cómo citar un dataset y un software.
Los tres errores que ve un comité
- Calcular para una prueba y correr otra. Es la inconsistencia que la revisión de 2026 detectó de forma recurrente. Si calculaste para una t y terminaste corriendo una ANOVA de tres grupos, el cálculo ya no respalda tu muestra.
- Reportar α y potencia pero no el tamaño del efecto ni su origen. Es exactamente el patrón de omisión que documenta ese estudio: se reporta lo fácil y se calla lo que sostiene el número.
- Presentar la potencia observada como justificación. Calcular la potencia con el efecto que ya obtuviste no aporta información nueva: es una reexpresión de tu valor p. Lo que sí es informativo, y muy útil cuando el resultado no salió significativo, es preguntarle a G*Power qué magnitud mínima de efecto era detectable con tu muestra final —la opción «Sensitivity: Compute required effect size»—. Eso convierte una limitación en un dato, y es la respuesta correcta cuando tu resultado no salió significativo.
Y si tu diseño no aparece en el menú
G*Power cubre las pruebas más comunes, no todas. Para modelos multinivel, ecuaciones estructurales o diseños longitudinales complejos, la vía es otra: paquetes específicos de R o simulación. Si tu tesis es cualitativa, el tamaño de muestra no se calcula con potencia: se justifica por saturación o por criterio teórico, como se explica en tipos de muestreo y en población y muestra en una tesis.
Una vez que tengas el número, lo que sigue es redactar el apartado que lo sostiene con los seis elementos completos. Tesify te ayuda a armar ese borrador con tus propios parámetros y con la estructura que suelen exigir los comités mexicanos; el criterio metodológico —qué efecto asumes y por qué— sigue siendo tuyo, y es la parte que se defiende.
Preguntas frecuentes
¿Cuándo uso G*Power en lugar de la fórmula de poblaciones finitas?
La fórmula sirve para estimar una proporción en una población con cierto margen de error. G*Power se usa cuando tu objetivo es contrastar una hipótesis: comparar grupos, correlacionar variables o ajustar un modelo de regresión. Son preguntas distintas y dan números distintos.
¿Qué potencia debo pedir?
La convención generalizada es 0.80, es decir, 80 % de probabilidad de detectar el efecto si realmente existe. Algunos programas piden 0.90 cuando el estudio tiene implicaciones clínicas. Reporta siempre el valor que usaste junto con el nivel de significancia.
¿De dónde saco el tamaño del efecto si todavía no tengo datos?
En orden de preferencia: de un estudio previo con el mismo instrumento y población parecida, de un metaanálisis del área, de tu propia prueba piloto o, como último recurso, de las convenciones de Cohen. Lo que no se vale es tomarlo de tus datos definitivos.
¿Puedo calcular la potencia después de recolectar?
Sí, pero elige bien qué calculas. La potencia observada a partir del efecto obtenido no aporta información nueva. Lo que sí sirve es la opción de sensibilidad: qué magnitud de efecto era detectable con la muestra que alcanzaste.
¿G*Power es gratuito?
Sí, es un programa gratuito para Windows y macOS desarrollado en la Universidad Heinrich Heine de Düsseldorf, y se cita como cualquier otro software en tu metodología.
¿Qué hago si el número que arroja es imposible de alcanzar?
No lo bajes en silencio. Tienes tres salidas legítimas: aumentar el tamaño del efecto mínimo que consideras relevante y argumentar por qué, simplificar el diseño para que requiera menos casos, o declarar la limitación y reportar qué efecto sí podrás detectar. Las tres se defienden; disfrazar la cifra, no.