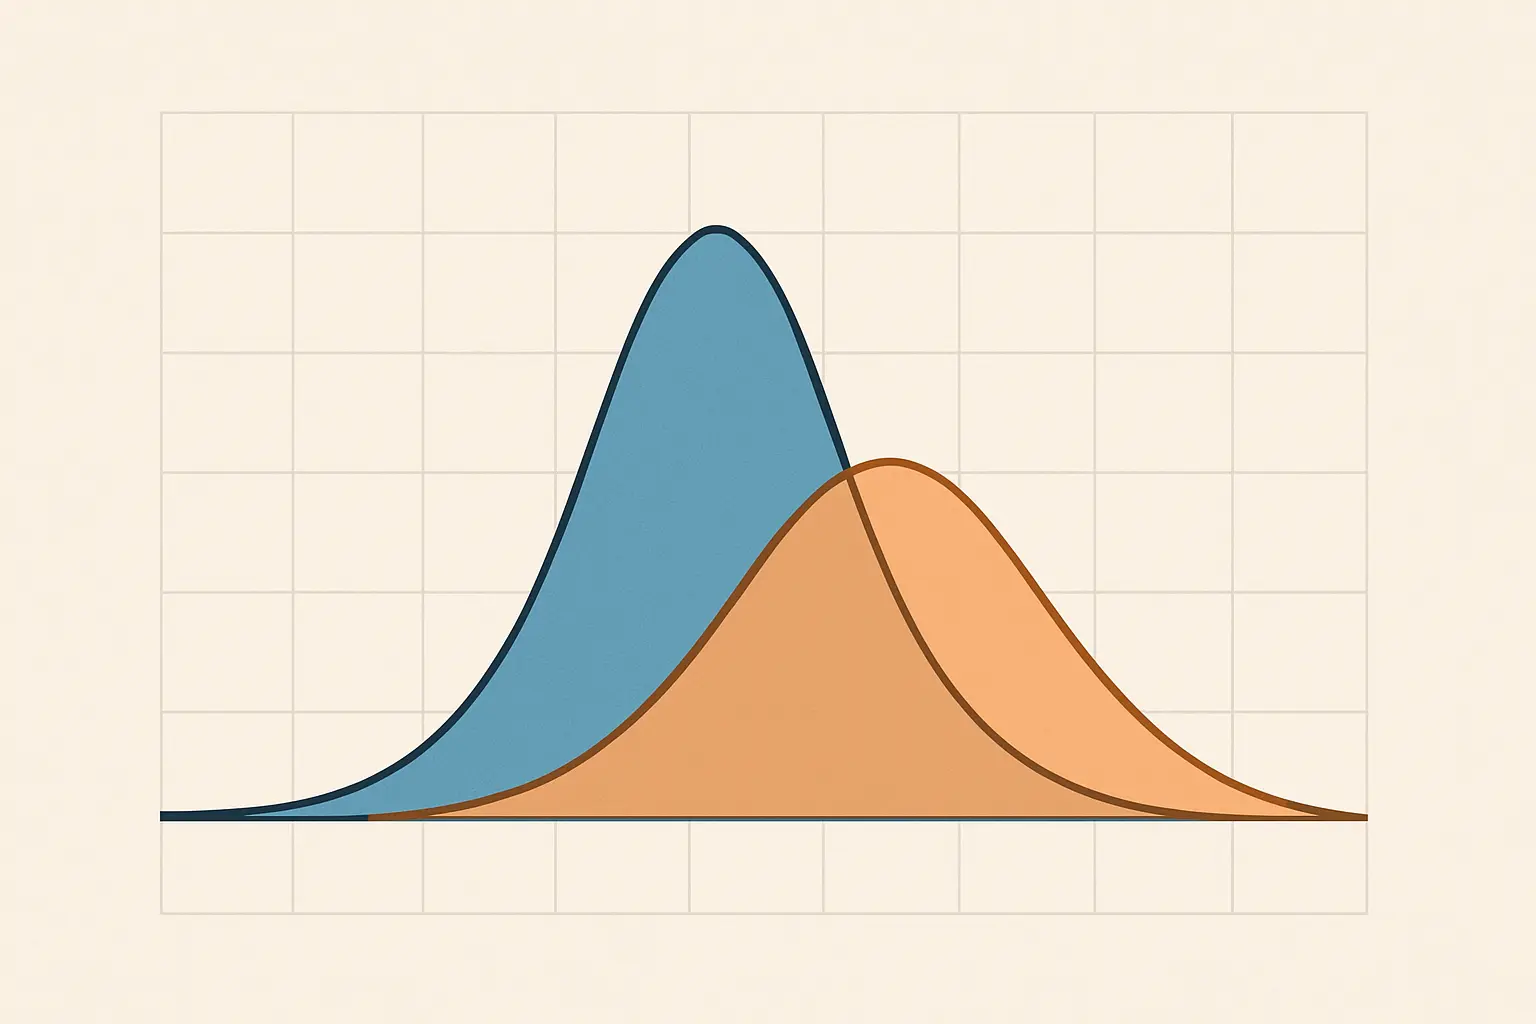
Respuesta corta: la prueba de Levene revisa si dos o más grupos tienen una dispersión parecida, no si tienen promedios parecidos. Es un requisito de la prueba t y del ANOVA. Aquí la lógica está invertida: un valor de significancia mayor a .05 es la buena noticia, porque quiere decir que puedes suponer varianzas iguales.
Corriste tu prueba t en SPSS, apareció una tabla con dos filas casi idénticas y arriba una columna que dice «Prueba de Levene de igualdad de varianzas». Nadie te explicó qué hacer con ella y estás a punto de copiar la primera fila porque se ve más bonita. Esta guía resuelve exactamente ese punto: qué mide, cómo se lee, cuál fila te toca y qué escribir en tu capítulo.
¿Qué mide exactamente?
La media te dice dónde está el centro de un grupo. La varianza te dice qué tan repartidos están los casos alrededor de ese centro. Son cosas distintas y puedes tener dos grupos con exactamente el mismo promedio y comportamientos completamente diferentes.
Piensa en dos grupos de estudiantes con promedio 8.0. En el primero casi todos sacaron entre 7.6 y 8.4. En el segundo hay quien sacó 5.0 y quien sacó 10.0. El promedio no distingue esos dos mundos; la varianza sí. La prueba de Levene es la que pone ese contraste en un número.
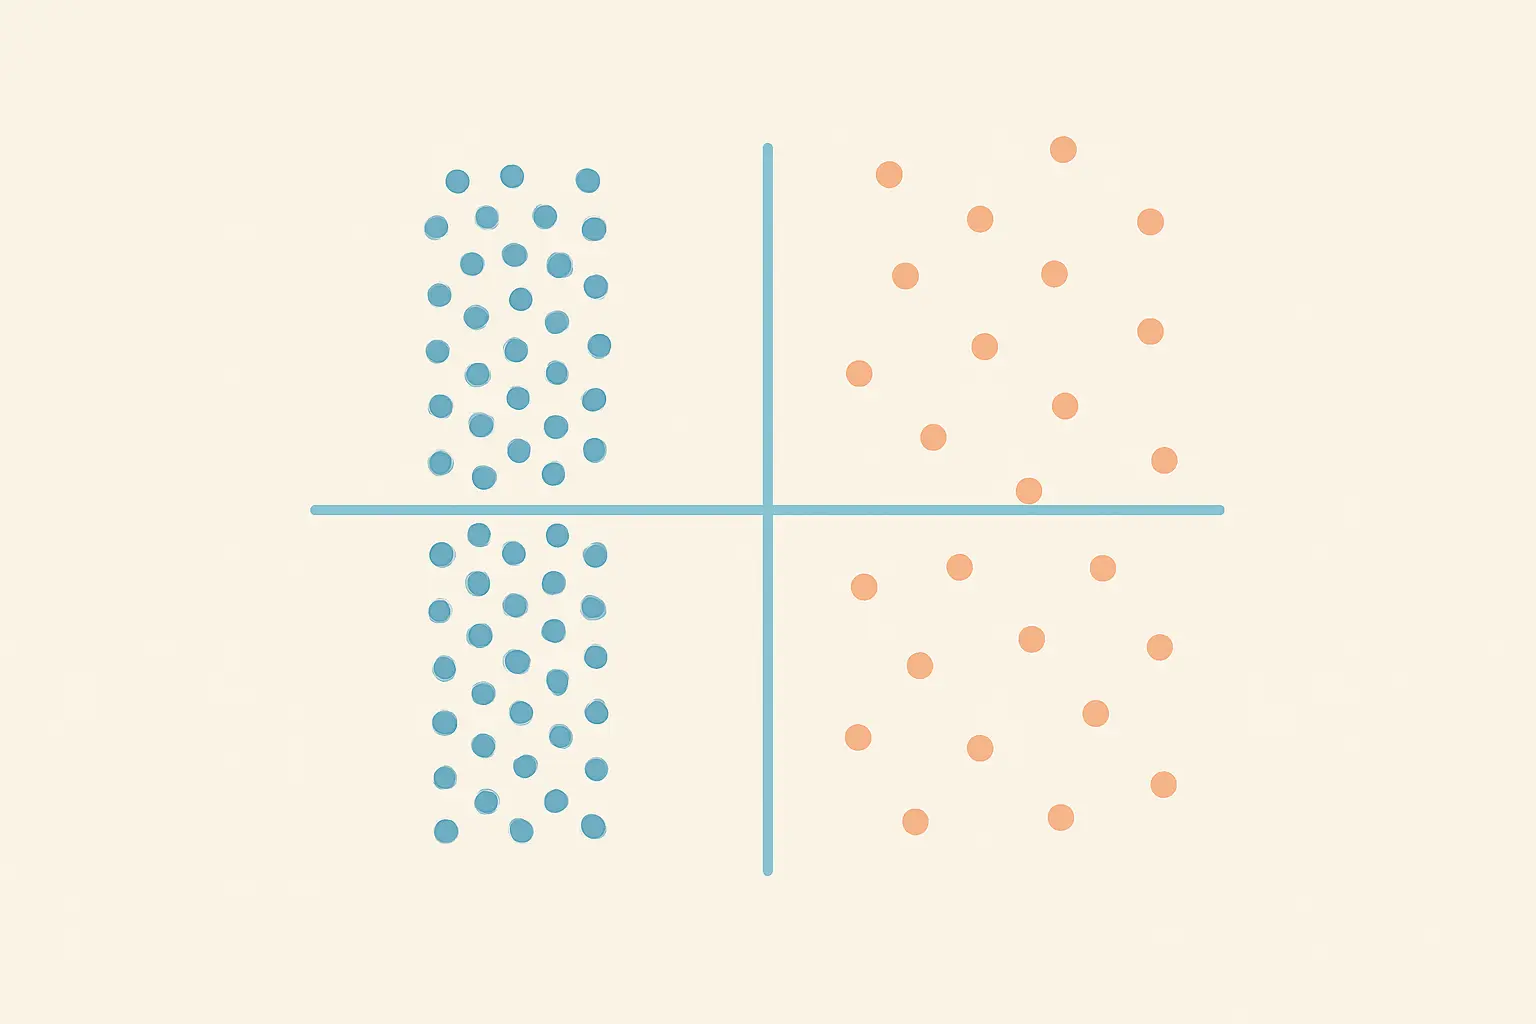
Su hipótesis nula es que las varianzas poblacionales de los grupos son iguales, lo que la literatura llama homocedasticidad. Formalmente lo que hace es tomar la distancia absoluta de cada caso respecto al centro de su grupo y correr un ANOVA sobre esas distancias. Si las distancias promedio difieren mucho entre grupos, la prueba se vuelve significativa.
Ese detalle importa para la réplica: la versión original de Levene usaba la media del grupo como centro, y la variante que hoy es estándar —propuesta por Brown y Forsythe (1974) en Journal of the American Statistical Association, 69(346), 364-367— usa la mediana, porque aguanta mucho mejor los datos asimétricos y con valores extremos. SPSS reporta las dos y algunas más en la misma tabla. Si tu variable tiene colas largas, la fila basada en la mediana es la que conviene reportar, y conviene decir cuál usaste.
La lógica invertida, en una tabla
| Sig. de Levene | Qué concluyes | Qué haces |
|---|---|---|
| Mayor a .05 | No hay evidencia de que las varianzas difieran | Puedes suponer varianzas iguales. En la prueba t, lees la primera fila |
| Menor o igual a .05 | Las varianzas difieren de forma detectable | No supones varianzas iguales. En la prueba t, lees la segunda fila (Welch); en ANOVA, pasas a Welch o Brown-Forsythe |
Es la misma inversión que tienen las pruebas de supuestos en general: no estás buscando un asterisco, estás buscando que no aparezca. Y como en todas ellas, «no rechazar» no es «demostrar»: con una muestra chica la prueba tiene poca potencia y un Sig. alto puede significar simplemente que no alcanzaste a ver una diferencia que sí existe. Cuántos casos necesitabas de origen se calcula desde el diseño, no después, y está resuelto en la guía de cómo calcular el tamaño de la muestra.
Dónde aparece en SPSS y cómo se lee
No tienes que pedirla por separado en la mayoría de los casos: SPSS la incluye automáticamente.
- Prueba t para muestras independientes (Analizar → Comparar medias → Prueba T para muestras independientes): la tabla de resultados trae las dos primeras columnas dedicadas a Levene y luego dos filas por cada variable. La fila «Se asumen varianzas iguales» y la fila «No se asumen varianzas iguales».
- ANOVA de un factor (Analizar → Comparar medias → ANOVA de un factor → botón Opciones → marcar «Prueba de homogeneidad de varianzas»). Ahí la tabla sale aparte, con las cuatro variantes de Levene.
- Explorar (Analizar → Estadísticos descriptivos → Explorar → Gráficos → «Gráficos con pruebas de normalidad») también la devuelve cuando pasas una variable de agrupación a la Lista de factores.
La confusión más común es leer la columna de Levene como si fuera el resultado de tu hipótesis. No lo es. Levene solo decide cuál de las dos filas de la prueba t es la que vas a reportar. Tu hipótesis se resuelve en la columna de significancia bilateral, más a la derecha. Si todavía no tienes claro qué prueba corresponde a tu diseño, esa decisión previa está en la guía de análisis de datos cuantitativos, que trae la tabla de equivalencias completa.
El debate que tu sinodal quizá conoce: ¿hace falta correrla?
Aquí hay una discusión metodológica real y vale la pena que la sepas, porque te puede caer en el examen.
La secuencia clásica —correr Levene y elegir la prueba t según el resultado— es lo que en la literatura se llama un test preliminar. Zimmerman (2004), en British Journal of Mathematical and Statistical Psychology, 57(1), 173-181, argumentó que condicionar la elección de la prueba al resultado de un test previo sobre los mismos datos distorsiona las tasas de error del procedimiento completo, y que en la práctica suele salir mejor no hacer la selección condicional.
En la misma dirección, Delacre, Lakens y Leys (2017), en International Review of Social Psychology, 30(1), 92-101, sostienen que la prueba t de Welch —la que no supone varianzas iguales— debería usarse por defecto en lugar de la de Student, porque mantiene un buen desempeño cuando las varianzas son desiguales y pierde muy poco cuando son iguales.
Traducción para tu tesis, sin dramatizar: si tu comité espera la secuencia clásica, córrela y repórtala; es lo que está en todos los manuales y en todas las plantillas. Si quieres blindar el capítulo, la jugada más defendible es reportar Levene y además usar la fila de Welch, explicando en una línea por qué. Un sínodo metodológico lo va a leer como criterio, no como error. Lo que no conviene es correr Levene, que salga significativa y aun así reportar la primera fila porque el valor p te gustaba más.
Cómo se escribe en el capítulo
Se reporta como cualquier F: el estadístico, los dos grados de libertad y la significancia.
| Situación | Cómo se redacta |
|---|---|
| Se cumple el supuesto | La prueba de Levene no mostró evidencia de heterogeneidad de varianzas, F(1, 118) = 0.87, p = .353, por lo que se aplicó la prueba t para varianzas iguales. |
| No se cumple | Las varianzas resultaron desiguales, F(1, 118) = 6.42, p = .013, por lo que se reporta la corrección de Welch. |
| ANOVA con tres grupos | El supuesto de homogeneidad no se sostuvo, F(2, 147) = 4.91, p = .009 (Levene basada en la mediana), por lo que se empleó el ANOVA de Welch. |
Ese párrafo va en el capítulo de resultados, justo antes de la prueba principal y después de los descriptivos; dónde encaja cada bloque está en cómo redactar el capítulo de resultados, y la forma de describir todo el aparato en el capítulo tres está en el ejemplo completo de metodología.
Cinco errores que cuestan una ronda de correcciones
- Aplicarla a una variable categórica. Sexo, turno o carrera no tienen varianza que comparar. La prueba corre y devuelve números sin significado.
- Correrla sobre un solo ítem de una escala en lugar del puntaje total. El objeto de análisis es la dimensión o el instrumento completo, como se explica en la guía de escala de Likert para tesis.
- Confundirla con la prueba de normalidad. Son dos supuestos distintos: uno mira la forma de la distribución, el otro la dispersión entre grupos. Puedes cumplir uno y fallar el otro.
- Reportar la primera fila «porque sale significativa». Es la versión estadística de escoger el resultado que conviene, y es exactamente lo que un lector con formación metodológica revisa primero.
- No decir cuál variante usaste. SPSS imprime cuatro. Si tus datos son asimétricos y reportas la basada en la media sin decirlo, estás reportando la menos robusta sin saberlo.
Si no usas SPSS
La lógica no cambia. En jamovi la prueba de Levene aparece marcando «Homogeneity test» dentro del análisis de t de muestras independientes o de ANOVA. En R está en car::leveneTest(), que por defecto usa la mediana, y la t de Welch es el comportamiento por defecto de t.test(). La comparación de fondo entre las tres opciones —costo, curva de aprendizaje, qué análisis soporta cada una— está en SPSS vs jamovi vs R para tesis.
Cuando ya tengas la tabla y la decisión tomada, lo que suele frenar es redactar el párrafo con la sintaxis exacta y sostener el mismo criterio a lo largo de todo el capítulo. Tesify te ayuda a armar ese borrador a partir de tus propios resultados y con la estructura que piden los comités mexicanos; verificar cada cifra contra tu salida sigue siendo tuyo, y con esta guía te toma una tarde.
Preguntas frecuentes
¿Qué significa que la Sig. de Levene sea mayor a .05?
Que no hay evidencia suficiente para afirmar que las varianzas de los grupos son distintas, así que puedes trabajar bajo el supuesto de homogeneidad y leer la fila «Se asumen varianzas iguales» de tu prueba t. En esta prueba un valor alto es la buena noticia.
¿La prueba de Levene revisa la normalidad?
No. Levene revisa la igualdad de varianzas entre grupos; la normalidad es un supuesto distinto que se evalúa con Shapiro-Wilk y con gráficos. Un análisis puede cumplir uno y fallar el otro, y cada uno tiene su propia salida.
¿Qué hago si la prueba de Levene sale significativa?
No se cancela nada. En la prueba t para muestras independientes lees la segunda fila, la de Welch, que corrige los grados de libertad. En ANOVA se usa el ANOVA de Welch o el de Brown-Forsythe. Solo tienes que decir en el texto que lo hiciste y por qué.
¿Cuál de las cuatro filas de Levene reporto en SPSS?
La basada en la mediana es la opción más robusta y es la variante de Brown y Forsythe (1974). Si tu variable es razonablemente simétrica, la basada en la media da prácticamente lo mismo. Elige una, dilo en el texto y mantén el criterio en todo el capítulo.
¿Necesito la prueba de Levene si mis grupos tienen el mismo número de casos?
Con grupos de tamaño igual la prueba t tolera mejor las varianzas desiguales, pero el supuesto sigue existiendo y los comités siguen pidiendo la evidencia. Repórtala; cuesta dos renglones y evita la pregunta en el examen.
¿Aplica si mi tesis es cualitativa?
No. Los supuestos de homogeneidad y normalidad pertenecen al análisis estadístico inferencial. En un diseño cualitativo lo que documentas son los criterios de rigor de tu instrumento y tu procedimiento, empezando por la validez y confiabilidad del instrumento y la definición de tus categorías en la operacionalización de variables.