La prueba de normalidad no te dice si tus datos «están bien». Te dice si puedes usar una prueba paramétrica. Y su lógica está invertida respecto a todo lo demás que has corrido en SPSS: aquí un valor de significancia mayor a .05 es la buena noticia. Esta guía te lleva del menú a la tabla, y de la tabla a la decisión que vas a escribir en tu capítulo.
Son las once de la noche, ya capturaste tus 120 cuestionarios y necesitas saber si aplicas una prueba t o una U de Mann-Whitney. El asesor te dijo «primero corre normalidad» y colgó. Esta guía resuelve exactamente ese punto: qué ruta de menú tocar, qué fila de la tabla leer, y qué hacer con las tres situaciones incómodas que casi nadie te explica (que las dos pruebas se contradigan, que con muestra grande todo salga «no normal», y que en regresión estabas probando la variable equivocada).
Si todavía no sabes qué prueba estadística corresponde a tu diseño, esa decisión previa está resuelta en la guía de análisis de datos cuantitativos, que trae la tabla de equivalencias entre pruebas paramétricas y no paramétricas. Aquí damos por hecho que ya la revisaste y que lo que te falta es el diagnóstico.
Qué estás probando en realidad
La hipótesis nula de toda prueba de normalidad es que tus datos provienen de una población con distribución normal. No que sean normales: que no hay evidencia suficiente para afirmar que no lo son. Esa diferencia parece de manual, pero es la que produce el error más común en las defensas.
La consecuencia práctica es la inversión que te adelantamos:
- Sig. mayor a .05 → no rechazas la hipótesis nula → puedes trabajar bajo el supuesto de normalidad → pruebas paramétricas.
- Sig. menor o igual a .05 → rechazas la nula → la distribución se aparta de la normal → pruebas no paramétricas o alguna alternativa robusta.
Ojo con el matiz: «no rechazar» no es «demostrar». Un estudio de simulación publicado en BMC Medical Research Methodology en 2025, que comparó trece pruebas de normalidad mediante simulaciones Monte Carlo con 10,000 réplicas por escenario, documenta que con muestras pequeñas las pruebas tienden a no rechazar la nula aunque la distribución sí se aparte, simplemente porque les falta potencia para detectarlo. Con n = 20 o n = 30 casi todas las pruebas evaluadas mostraron potencia baja. Es decir: con muestra chica, un «Sig. = .40» no es prueba de normalidad, es falta de información.
La ruta en SPSS, paso a paso
SPSS ofrece dos caminos. El que debes usar es Explorar, porque devuelve en una sola corrida el estadístico, los gráficos y los descriptivos de forma.
- Abre tu base y ve a Analizar → Estadísticos descriptivos → Explorar.
- Pasa tu variable dependiente (la numérica que vas a analizar) al cuadro Lista de dependientes.
- Si vas a comparar grupos, pasa la variable de agrupación a Lista de factores. Esto es importante: en una comparación de grupos la normalidad se evalúa dentro de cada grupo, no en la muestra completa revuelta.
- Entra al botón Gráficos y marca Gráficos con pruebas de normalidad. Marca también Histograma.
- En el botón Estadísticos deja activados los descriptivos: ahí vienen la asimetría y la curtosis con sus errores estándar.
- Acepta. En el visor busca la tabla titulada Pruebas de normalidad.
Esa tabla trae dos filas de resultados por variable (o por grupo, si usaste factores): Kolmogorov-Smirnov con la corrección de significación de Lilliefors y Shapiro-Wilk. Cada una con su estadístico, sus grados de libertad (gl, que es tu n) y su Sig.
¿Shapiro-Wilk o Kolmogorov-Smirnov? La regla corta
Reporta Shapiro-Wilk. Es la recomendación por defecto y tiene sustento en la evidencia comparativa reciente: el mismo estudio de 2025 concluye que, en datos con asimetría marcada, Shapiro-Wilk es la prueba más efectiva de las trece evaluadas, y que en datos con asimetría moderada y curtosis baja se desempeña entre las mejores en todos los tamaños de muestra. La prueba de Lilliefors, en cambio, quedó entre las que mantienen potencia débil incluso con curtosis moderada.
El origen de la confusión merece un párrafo, porque te va a servir en la réplica. La Kolmogorov-Smirnov clásica compara la función de distribución acumulada de tu muestra contra la de una distribución completamente especificada —es decir, una cuya media y desviación estándar conoces de antemano—. En una tesis no las conoces: las estimas de tus propios datos. Lilliefors corrigió los valores críticos precisamente para ese caso, y eso es lo que SPSS reporta. Por eso la etiqueta dice «con corrección de significación de Lilliefors»: no es un adorno, es la aclaración de que estás usando una versión adaptada.
Shapiro-Wilk funciona con otra lógica: calcula la correlación entre tus datos observados y las puntuaciones normales que les corresponderían. Su estadístico va de 0 a 1 y los valores cercanos a 1 indican cercanía a la normalidad. Esa es la lectura del número que aparece en la columna «Estadístico» y que casi nadie reporta.
Las tres situaciones que descarrilan el capítulo
1. Las dos pruebas se contradicen
Pasa seguido: Lilliefors dice .200 y Shapiro-Wilk dice .012. No es un error de SPSS; son pruebas con sensibilidades distintas. La salida correcta no es escoger la que te conviene, sino tomar la decisión con los tres elementos juntos. La literatura metodológica es explícita en que los métodos gráficos por sí solos son subjetivos y que conviene complementarlos con estadísticos descriptivos y con una prueba formal. Aplicado a tu tesis, eso significa mirar:
- El Shapiro-Wilk como prueba formal de referencia.
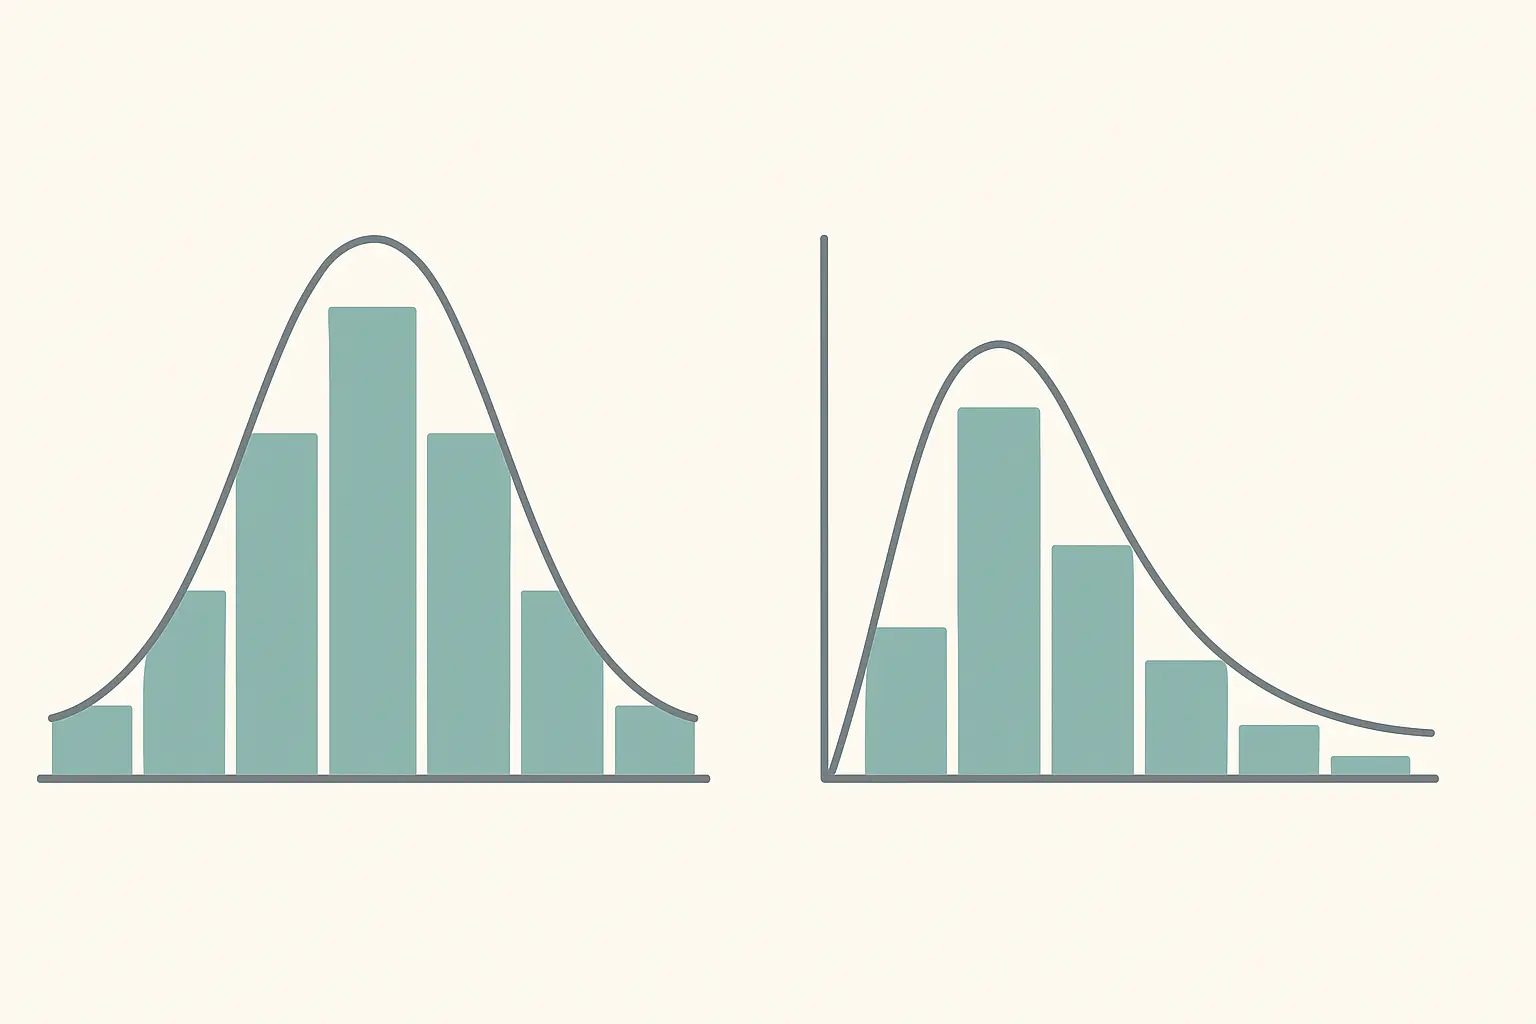
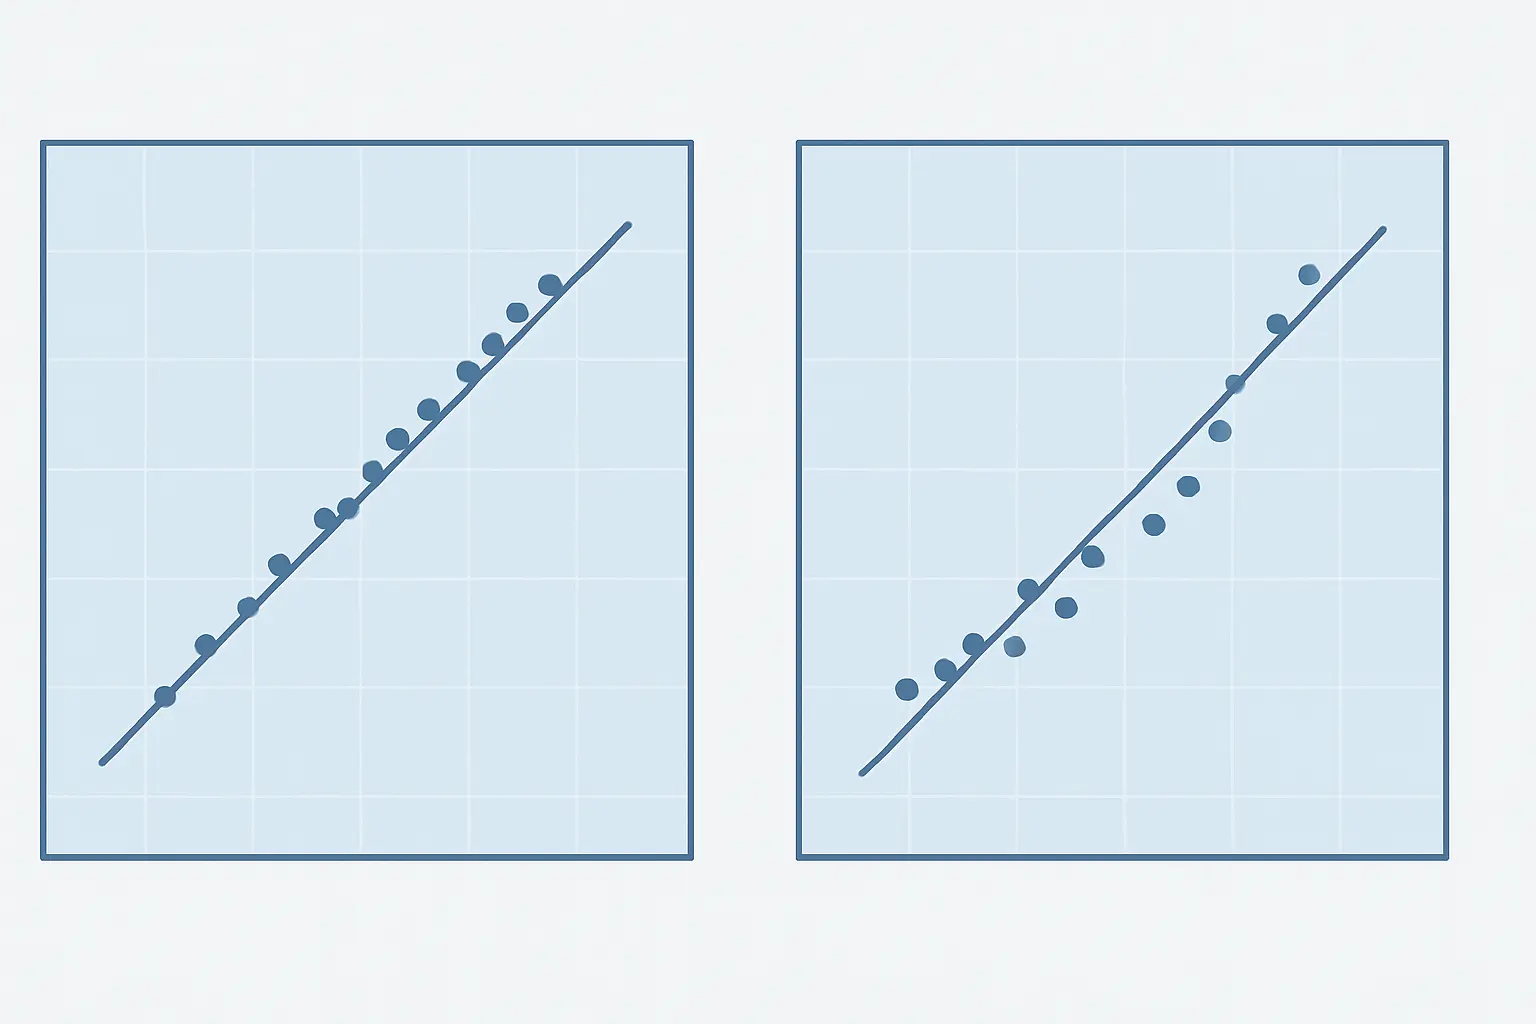
- El gráfico Q-Q normal, que Explorar ya te generó: si los puntos se pegan a la diagonal, la desviación es menor; si se curvan en los extremos, tienes colas problemáticas.
- La asimetría y la curtosis: divide cada una entre su error estándar; valores fuera del rango aproximado de −2 a +2 señalan una desviación que sí importa.
Cuando los tres apuntan al mismo lado, escribe esa conclusión y sigue. Cuando no, documenta la discrepancia en el texto y justifica la decisión: un sínodo acepta mucho mejor «las pruebas discrepan, opté por la vía no paramétrica por prudencia» que un reporte selectivo.
2. Tu muestra es grande y «todo sale no normal»
Con 400 o 500 casos es normal que Shapiro-Wilk salga significativo aunque el histograma se vea perfectamente acampanado. No estás haciendo nada mal. La razón está documentada en la literatura metodológica que recoge el estudio de 2025: con muestras grandes, las pruebas de normalidad pueden arrojar resultados significativos ante desviaciones muy pequeñas, mientras que la inferencia paramétrica tolera bien esas desviaciones pequeñas justamente cuando la muestra es grande.
Traducido: la prueba detecta una diferencia real pero trivial, y tú la estás tratando como si fuera decisiva. Con n grande, deja que el tamaño de la desviación —el Q-Q, la asimetría estandarizada— pese más que el asterisco. Y déjalo escrito así en tu capítulo, con la referencia; es de los párrafos que mejor impresión causan porque demuestra que entiendes la herramienta y no solo la ejecutas. Si aún estás definiendo cuántos casos necesitas, la guía para calcular el tamaño de la muestra te da la fórmula y los parámetros.
3. Tu análisis es una regresión y probaste la variable equivocada
Este es el error silencioso, y su magnitud está medida. Un estudio publicado en Royal Society Open Science en 2025 revisó de forma bibliométrica el uso de pruebas de normalidad en modelos de regresión lineal y encontró que más del 70 % de los artículos de ecología y más del 90 % de los de biología aplicaron la prueba a los datos crudos en lugar de a los residuos del modelo. En una regresión, el supuesto de normalidad no recae sobre la variable dependiente: recae sobre los residuos.
La misma investigación aporta un dato que conviene citar con honestidad: al simular ambos enfoques, las diferencias de potencia estadística entre probar los datos crudos y probar los residuos resultaron mínimas, y cuando los residuos sí violaban el supuesto, cambiar a una prueba no paramétrica aportó entre 3 y 4 puntos porcentuales de potencia. O sea: el error es real y hay que corregirlo, pero no invalida tus resultados por sí solo. Esa es exactamente la respuesta que necesitas si un sinodal te lo señala.
Para hacerlo bien en SPSS: corre tu regresión en Analizar → Regresión → Lineales, entra a Guardar y marca Residuos no tipificados. SPSS crea una variable nueva (RES_1) en tu base. Sobre esa variable corres Explorar con la prueba de normalidad.
Cómo se reporta en el capítulo
La convención en APA 7 es reportar el estadístico, los grados de libertad y la significancia, con el símbolo en cursiva y sin cero inicial en el valor de significancia:
| Situación | Cómo se escribe |
|---|---|
| Cumple el supuesto | La prueba de Shapiro-Wilk no mostró evidencia de desviación respecto a la normalidad, W(118) = .987, p = .312. |
| No cumple | La distribución se apartó significativamente de la normal, W(118) = .921, p < .001, por lo que se optó por pruebas no paramétricas. |
| Por grupos | El supuesto se cumplió en el grupo control, W(58) = .981, p = .478, pero no en el grupo experimental, W(60) = .930, p = .002. |
Tres reglas de formato que se marcan en revisión: el número de decimales, el cero inicial y cuándo escribir «p < .001» en lugar del valor exacto están resueltos en la guía de números en APA 7. Y la ubicación de este párrafo dentro del capítulo —antes de los resultados inferenciales, después de los descriptivos— está en cómo redactar el capítulo de resultados.
Errores que cuestan una ronda de correcciones
- Probar la normalidad de una variable categórica. Sexo, carrera o nivel socioeconómico no tienen distribución que evaluar. La prueba corre y devuelve números; los números no significan nada.
- Probar la muestra completa cuando comparas grupos. Dos grupos normales con medias muy separadas producen una distribución conjunta bimodal que fallará la prueba. Usa la Lista de factores.
- Aplicar la prueba a cada ítem de una escala Likert en lugar de al puntaje total. Un ítem individual de cinco puntos no puede ser normal. El objeto de análisis es la puntuación de la dimensión o del instrumento, como se explica en la guía de escala de Likert para tesis.
- Escribir «los datos son normales». Escribe «no se encontró evidencia de desviación respecto a la normalidad». Es más largo y es lo correcto.
- No reportar nada. Si tu capítulo aplica una prueba t sin una línea sobre el supuesto, el sínodo lo va a preguntar. Reportarlo cuesta dos renglones.
Si no usas SPSS
La lógica es idéntica en jamovi (Analyses → T-Tests → marcar Normality test, o Exploration → Descriptives → Shapiro-Wilk) y en R (shapiro.test(x)). Lo que cambia es la ruta, no la interpretación ni el reporte. La comparación de fondo entre las tres opciones —costo, curva de aprendizaje, qué análisis soporta cada una— está en SPSS vs jamovi vs R para tesis.
Cuando ya tengas la tabla y la decisión tomada, lo que suele frenar es redactar el párrafo con la sintaxis exacta y mantener la consistencia a lo largo de todo el capítulo. Tesify te ayuda a armar ese borrador con tus propios resultados y con la estructura que piden los comités mexicanos; verificar cada cifra contra tu salida de SPSS sigue siendo tuyo, y con esta guía te toma una tarde. Cómo encaja todo esto en el resto del capítulo metodológico está en el ejemplo completo de metodología.
Preguntas frecuentes
¿Qué significa que la Sig. sea mayor a .05 en la prueba de normalidad?
Que no hay evidencia suficiente para rechazar la hipótesis nula de normalidad, y por lo tanto puedes trabajar bajo ese supuesto y aplicar pruebas paramétricas. La lógica está invertida respecto a la mayoría de las pruebas: aquí un valor alto es la buena noticia.
¿Uso Shapiro-Wilk o Kolmogorov-Smirnov?
Reporta Shapiro-Wilk. La evidencia comparativa reciente la ubica como la más efectiva ante asimetría marcada y entre las mejores en asimetría moderada, mientras que la variante de Lilliefors que SPSS reporta muestra potencia más débil. Puedes mencionar ambas, pero la decisión se toma con Shapiro-Wilk apoyada en el gráfico Q-Q.
Mi muestra es de 500 y Shapiro-Wilk salió significativo, ¿qué hago?
Revisa el histograma, el gráfico Q-Q y la asimetría estandarizada antes de descartar el análisis paramétrico. Con muestras grandes la prueba detecta desviaciones muy pequeñas y las marca como significativas, aunque la inferencia paramétrica las tolere bien. Documenta esa decisión en el texto.
¿Se prueba la normalidad de la variable dependiente o de los residuos?
Depende del análisis. Para comparar grupos con prueba t o ANOVA, la normalidad se evalúa en la variable dependiente dentro de cada grupo. Para regresión lineal, el supuesto recae sobre los residuos del modelo, no sobre los datos crudos, y ese es el error más frecuente en la literatura publicada.
¿Puedo transformar mis datos si no cumplen normalidad?
Sí, es una alternativa legítima frente al cambio a pruebas no paramétricas, siempre que declares la transformación aplicada y reportes los resultados en la escala transformada. Lo que no es aceptable es probar varias transformaciones y reportar solo la que produjo significancia.
¿Tengo que hacer la prueba si mi tesis es cualitativa?
No. Las pruebas de normalidad pertenecen al análisis estadístico inferencial y no aplican a datos cualitativos. Lo que sí necesitas documentar en ese caso son los criterios de rigor de tu diseño, empezando por la validez y confiabilidad de tu instrumento.